Préparation des données
- Récupération des informations. L’API YouTube renvoie toutes les informations des vidéos : un JSON par vidéo avec notamment titre, description, durée...
- Téléchargement des vidéos. Téléchargement avec yt-dlp en 720p léger.
-
Traitement des vidéos.
L’objectif est d’extraire la transcription et les speakers de chaque vidéo, mais aussi de répondre aux questions suivantes :
-
Qui parle et à quel moment ?
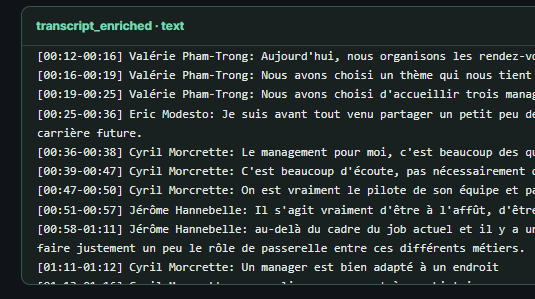 Exemple provisoire : le pipeline relie une
prise de parole à son intervenant et à son
timecode.
-
Y a-t-il des questions écrites à l'écran mais non
vocalisées ?
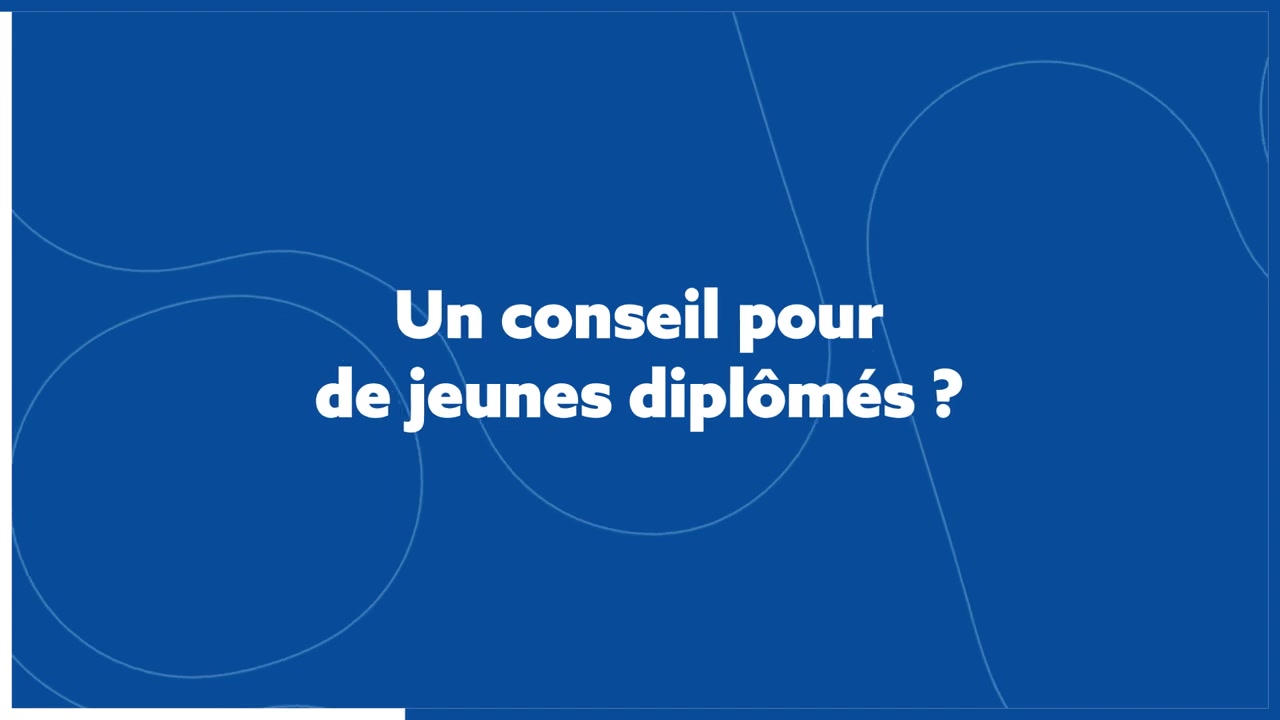 Exemple provisoire : l'OCR permet de conserver
une question visible, même sans voix dans la
vidéo.
-
Des sous-titres peuvent-ils corriger la transcription si
besoin ?
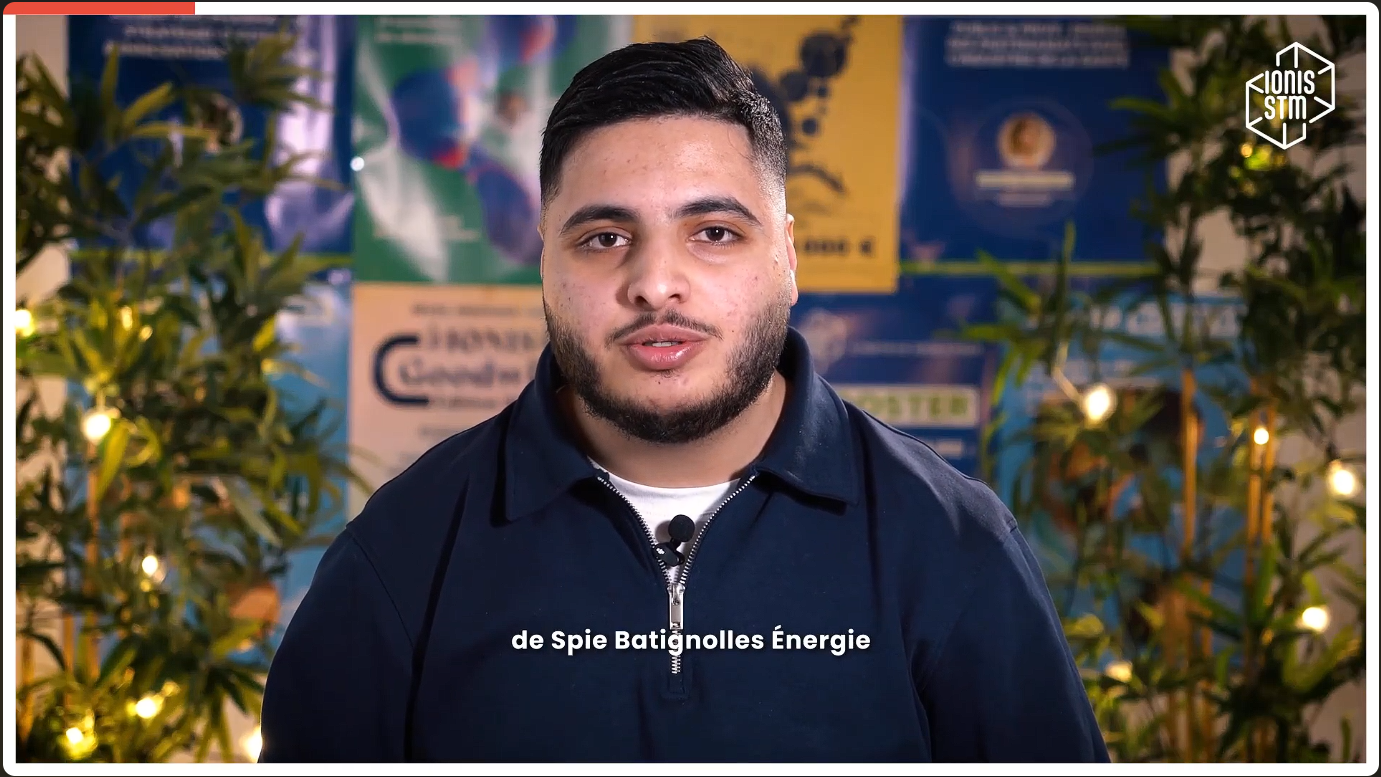 Exemple provisoire : les sous-titres apportent
un second signal pour corriger un mot mal
entendu.
-
Des informations sur les speakers sont-elles affichées
sans être vocalisées ?
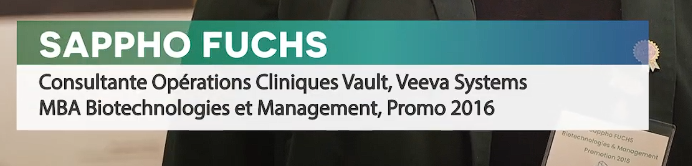 Exemple provisoire : un cartouche à l'écran
peut préciser le nom ou le rôle d'un
intervenant.
-
Quel est le type de vidéo ?
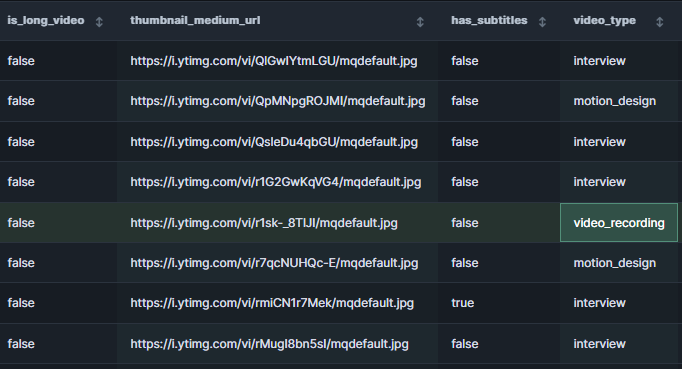 Exemple provisoire : le pipeline identifie le
format de la vidéo pour adapter son
traitement.
Chaque vidéo suit donc un pipeline de préparation stricte selon plusieurs paramètres détectés au fil du pipeline (vidéo très longue, interview, motion design, captation générale).
Cliquez ici pour voir le traitement en détail.
À la toute fin, le pipeline produit notamment un transcript enrichi (avec timecodes, speakers, questions posées) et un transcript classique. C'est le transcript classique qui est découpé en chunks, puis les chunks partent vers le modèle d'embedding.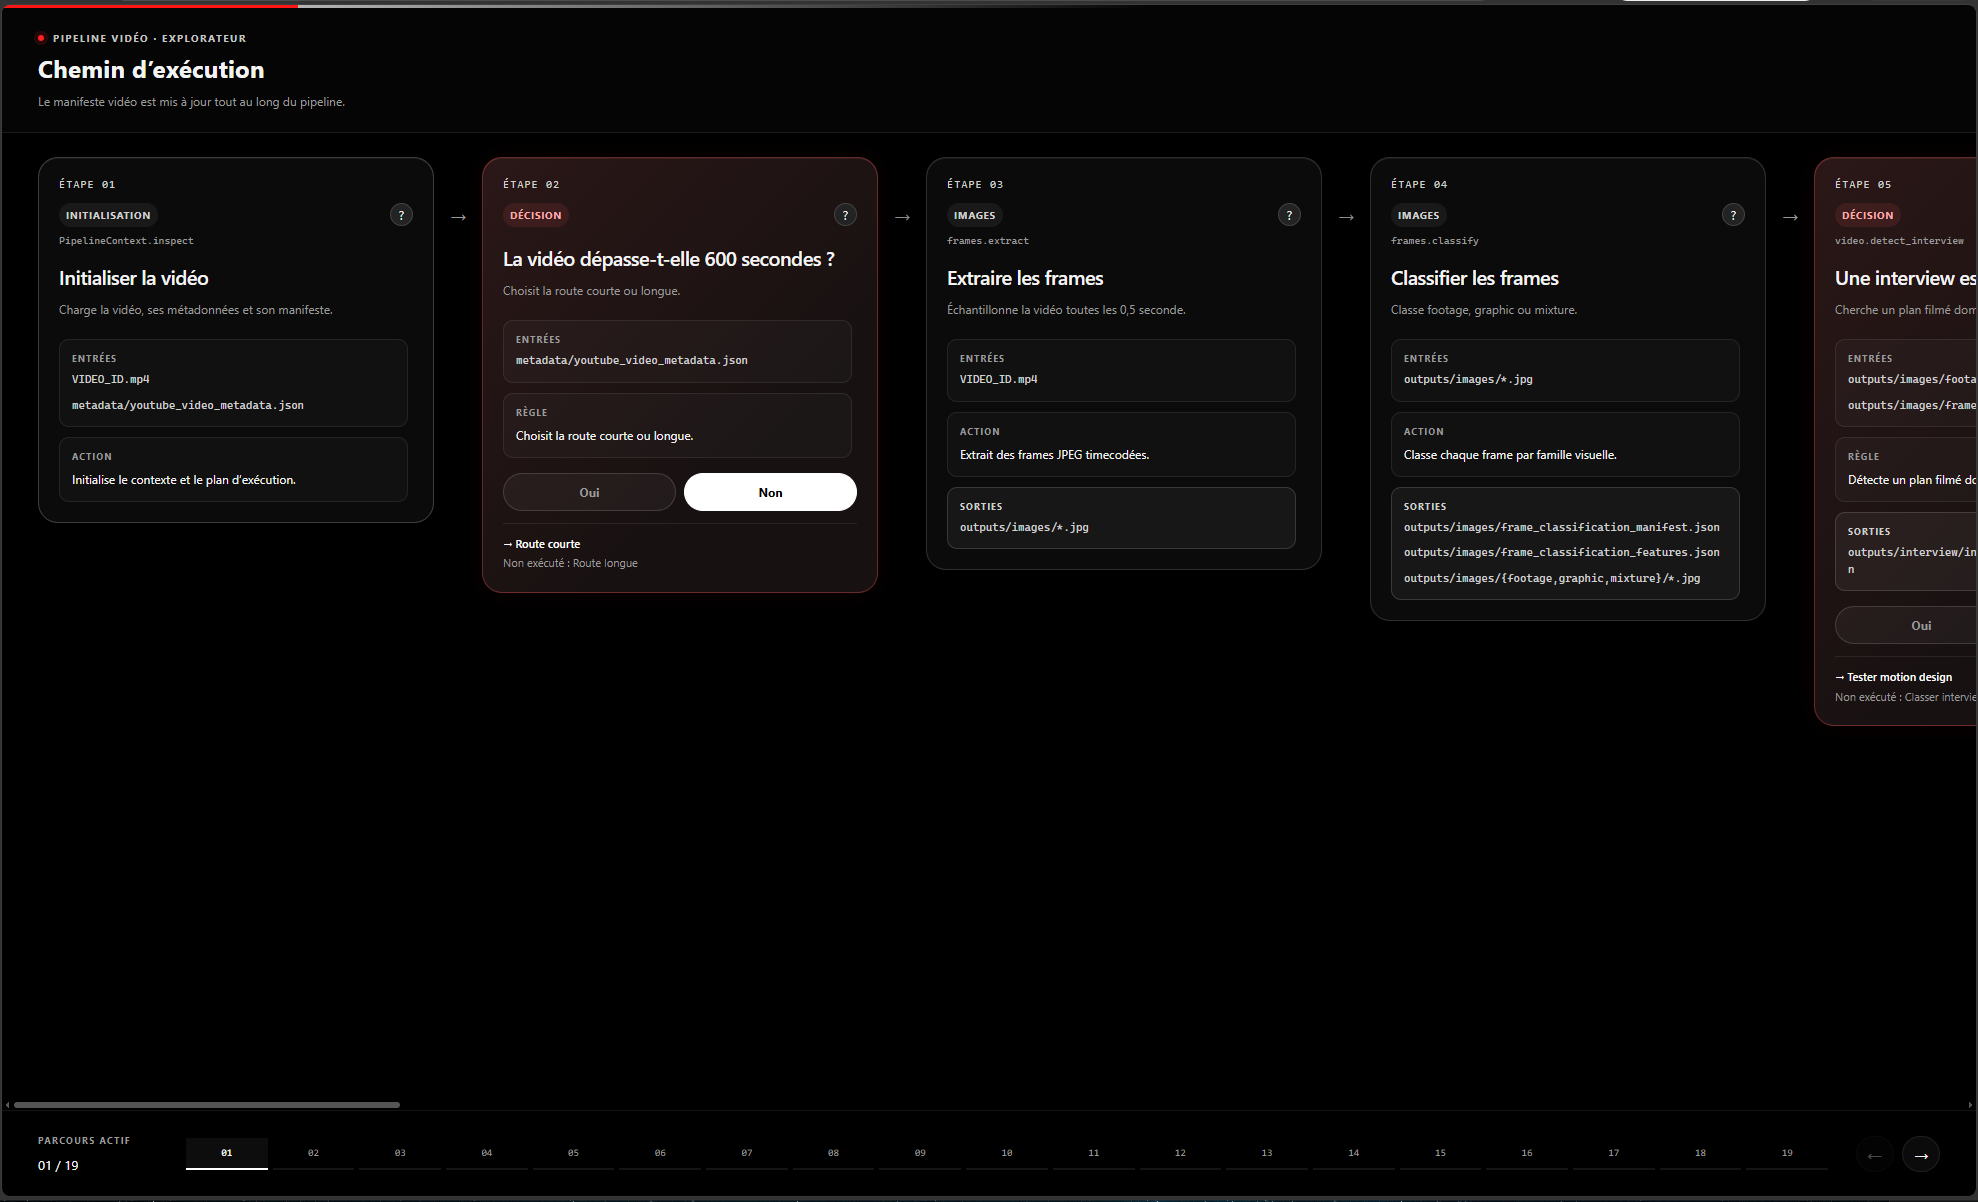
Aperçu de l'explorateur du pipeline de préparation — cliquez sur l'image pour l'ouvrir en grand. Exemple de transcript enrichi (timecodes, speakers, questions posées). Exemple de transcript classique, celui qui est découpé en chunks. -
Qui parle et à quel moment ?
Les vidéos sont téléchargées puis elles passent dans le pipeline de préparation, tout ceci est stocké chez Scaleway. La base PostgreSQL (avec l'extension pgvector) tourne dans un conteneur Docker sur le VPS ; ses données sont conservées dans un volume Docker persistant, qui survit aux redéploiements.


Le choix a été fait à partir d'un benchmark reproductible, mené sur les chunks réellement produits par le pipeline et 45 questions annotées. Il mesure si le bon chunk est retrouvé dans les premiers résultats (Recall@K) et à quel rang il apparaît (MRR).
Les résultats du test vectoriel sont les suivants :
| Configuration | Modèle | Dimensions | Recall@1 | Recall@5 | Recall@10 | MRR |
|---|---|---|---|---|---|---|
| small-512 | text-embedding-3-small |
512 | 64,4 % | 82,2 % | 88,9 % | 74,3 % |
| small-1024 | text-embedding-3-small |
1 024 | 62,2 % | 86,7 % | 88,9 % | 72,5 % |
| large-1024 | text-embedding-3-large |
1 024 | 62,2 % | 84,4 % | 91,1 % | 72,3 % |
| large-1536 | text-embedding-3-large |
1 536 | 66,7 % | 82,2 % | 93,3 % | 74,8 % |
| large-2000 | text-embedding-3-large |
2 000 | 66,7 % | 86,7 % | 93,3 % | 75,6 % |
| large-3072 | text-embedding-3-large |
3 072 | 66,7 % | 93,3 % | 93,3 % | 76,8 % |
Les quatre finalistes (small-1024, large-1024, large-2000 et
large-3072) ont ensuite été vérifiés dans les conditions de la
recherche hybride : recherche lexicale (full-text PostgreSQL,
classement ts_rank_cd proche de BM25), recherche
vectorielle, fusion RRF et reranking Cohere. Résultats après
reranking :
| Configuration | Recall@1 | Recall@5 | MRR |
|---|---|---|---|
| small-1024 | 80,0 % | 91,1 % | 85,6 % |
| large-1024 | 80,0 % | 93,3 % | 86,7 % |
| large-2000 | 80,0 % | 95,6 % | 87,1 % |
| large-3072 | 80,0 % | 95,6 % | 87,1 % |
Le modèle text-embedding-3-large est donc utilisé pour vectoriser les chunks. La version en 2 000 dimensions atteint 93,3 % de Recall@10 et 75,6 % de MRR sur le test vectoriel. En passant à 3 072 dimensions, le Recall@10 ne progresse pas et, après reranking, les deux tailles sont à égalité. Il ne sert donc à rien d'alourdir la base pour une amélioration aussi faible : 2 000 dimensions offrent le meilleur compromis entre qualité de recherche, stockage et temps de calcul.
En plus, cela tombe bien : 2 000 dimensions, c'est la taille maximale pour un index HNSW.
Chaque chunk conserve le lien vers sa vidéo d'origine (et vers son résumé parent éventuel pour les vidéos longues), dont on garde les métadonnées : identifiant YouTube, titre, description, URL, date de publication, durée, miniature, type de vidéo, présence de sous-titres, intervenants détectés et leurs rôles.
S'y ajoutent des données propres à chaque vidéo, interrogeables en SQL pour répondre directement à certaines questions : ses statistiques (vues, likes, nombre de commentaires) ainsi que ses commentaires et leurs réponses.
Pipeline de réponse
Le pipeline principal (hors agent utilisé si échec) utilise 5 rôles de LLM : reformulation, planification, génération SQL, génération de réponse et résumé de conversation. Ces rôles peuvent être assurés par un même modèle ou par des modèles différents, selon les besoins. Actuellement, c'est toujours le même modèle qui est utilisé pour tous les rôles (Mistral Medium 3.5).
Selon la route choisie et l’historique de la conversation, le pipeline passe couramment de 2 à 5 appels par question. Le résumé intervient lors d’un changement de sujet, plutôt qu’après un nombre fixe de messages.
| Exemple | Reformulation | Planification | SQL | Réponse | Résumé |
|---|---|---|---|---|---|
|
2 appels « J’ai besoin de la transcription de la vidéo de Salim. » |
✓ | ✓ | — | — | — |
|
3 appels « Pourquoi faire Ionis-STM ? » |
✓ | ✓ | — | ✓ | — |
|
4 appels « Quelle vidéo a le plus de vues ? » |
✓ | ✓ | ✓ | ✓ | — |
|
5 appels Question analytique après un changement de sujet |
✓ | ✓ | ✓ | ✓ | ✓ |
Après 10 sujets dans une même conversation, un appel supplémentaire pour résumer la conversation peut porter le total à 6. Ces nombres excluent l’embedding et le reranking Cohere.
Le pipeline de réponse passe par plusieurs étapes, que l'on peut voir ici.

Lorsque les éléments trouvés ne suffisent pas, le pipeline s'abstient au lieu d'inventer ou de répondre à une question voisine : « À première vue, je n'ai pas la réponse dans les vidéos », avec un bouton « Élargir la recherche ? ».
Ce bouton lance un agent autonome (avec Mistral Large 4). Il reçoit la question et le constat de l'abstention (ce que les vidéos couvrent et ce qui manque), puis reformule et décompose lui-même la question. Il dispose de trois outils :
-
recherche_via_embeddings: la même recherche hybride dans les vidéos que le pipeline classique, sans reranking Cohere. -
interroger_statistiques: le même Text-to-SQL que le pipeline classique, pour les statistiques des vidéos. -
web_search: la recherche web de Mistral, propre à l'agent, en dernier recours.
Si le pipeline principal est passé par la recherche vectorielle,
l'agent part de zéro : relancer la même recherche ramènerait les
mêmes passages, donc s'il cherche à nouveau dans les vidéos, il
doit reformuler ou décomposer la question. Pour les autres
routes, une première
recherche_via_embeddings sur la
question reformulée par le pipeline principal est faite avant
qu'il démarre. Il choisit ensuite lui-même les outils à appeler.
Il peut décomposer une question, par exemple une comparaison
entre deux entreprises, en plusieurs recherches. Il est limité à
3 appels aux outils vidéo, recherche initiale comprise le cas
échéant ; ses consignes lui demandent en outre de ne faire
qu'une seule recherche web. S'il s'apprête à répondre sans citer
de vidéo et sans avoir consulté le web, il est relancé une fois
pour l'y inciter.
Sa réponse s'affiche à part, avec les vidéos citées et les sources web : une information du web n'est jamais présentée comme venant des vidéos. Si l'agent répond d'après le web sans citer de page, les pages qu'il a consultées sont affichées comme sources ; si aucune vidéo ni aucune page ne l'étaye, sa réponse est remplacée par « Je n'ai rien trouvé de fiable dans les vidéos ni sur le web ».
Le pipeline est suivi dans Phoenix par des traces OpenTelemetry. Chaque requête laisse une chronologie des étapes : reformulation, planification, résolution d'entités, recherche, reranking, génération et persistance de la conversation.
Pour chaque étape, les traces permettent d'examiner la route choisie, les sources retrouvées, les scores de reranking, les appels aux modèles, les erreurs éventuelles et la durée d'exécution.
La mémoire est organisée par sujets de conversation. Le sujet en cours conserve les derniers échanges et les vidéos évoquées, ce qui permet de comprendre les relances sans que l’utilisateur ait à répéter le contexte.
Lorsqu’un nouveau sujet est détecté, le précédent est résumé et conservé parmi les sujets passés. Après dix sujets dans une même conversation, leurs résumés sont consolidés dans un résumé global, afin de garder les informations importantes sans alourdir le contexte transmis aux modèles.
follow_up indique s’il y a un changement de sujet
ou non.
Statistiques et performance
Ces chiffres proviennent du dernier benchmark Phoenix sur le golden dataset, du 13 octobre 2026 : 75 questions sur 75 ont abouti. Les 9 dernières questions du dataset, ajoutées après ce benchmark, servent à tester l'abstention et la recherche élargie.
Le recall mesure la couverture des éléments attendus ; la précision mesure la part de résultats retournés qui sont effectivement pertinents.
- Vidéos — recall
- 88,0 %
- Vidéos — précision
- 58,6 %
- Vidéos via route SQL — recall / précision
- 90,0 % / 75,0 %
- Vidéos via route vectorielle — recall / précision
- 84,0 % / 25,7 %
- Chunks — recall / précision
- 84,0 % / 17,6 %
- Route attendue
- 93,3 %
- Coût moyen par question
- 0,0063 $
- Latence « réponse prête » — P50 / P75 / P90 / P95
- 3,74 s / 4,51 s / 5,33 s / 5,68 s
Part des vidéos attendues que le RAG retrouve.
Plus
haut signifie moins de sources pertinentes manquées.
Part des vidéos retournées qui sont pertinentes.
Plus
haut signifie moins de résultats hors sujet.
Mesure les vidéos des requêtes traitées en SQL.
Recall
: couverture ; précision : pertinence des retours.
Mesure les vidéos des requêtes traitées par recherche
sémantique.
Recall : couverture ; précision :
pertinence des retours.
Mesure les passages attendus après la recherche et le
rerank.
Recall : passages retrouvés ; précision :
passages utiles.
Part des questions envoyées vers la bonne route SQL ou
vectorielle.
Plus haut signifie un meilleur aiguillage
initial.
Estimation du coût des appels LLM pour une question
complète.
Elle inclut reformulation, planification,
réponse et Text-to-SQL lorsqu’il est appelé.
Temps entre l’envoi de la question et la réponse
enregistrée, prête à être renvoyée.
Percentiles
calculés sur les 75 réponses du dernier benchmark.
Mise à jour du contenu
Un appel à l’API YouTube est effectué une fois par semaine via une tâche cron. La dernière liste de vidéos récupérée est ensuite comparée à celles déjà présentes dans PostgreSQL. Les vidéos déjà publiées sont ignorées. Pour chaque vidéo absente, ses informations sont récupérées via l’API YouTube, puis elle passe dans le pipeline de préparation. Chaque mise à jour s’exécute dans un conteneur Docker éphémère sur le VPS, lancé par la tâche cron puis supprimé une fois terminée. Ce conteneur léger ne contient que le code de mise à jour ; il interroge l’API YouTube, la base PostgreSQL et, pour les nouvelles vidéos, pilote la VM GPU.
docker compose -f docker-compose.yml -f docker-compose.prod.yml \
  --env-file .env.production \
  --profile jobs run --rm updater python -m pipeline.update_videos
Une vidéo n'est rendue disponible au RAG qu'une fois ce parcours
terminé. En cas d'échec, elle reste absente de la table des
vidéos et sera donc automatiquement retentée à la prochaine
exécution. Chaque exécution crée dans le stockage objet Scaleway
un dossier daté, par exemple
youtube/20260912_1411_update_videos/, qui conserve
la liste des vidéos détectées (new_videos.json) et
le journal des traitements réalisés
(update_videos_log.json) ; son chemin est aussi
enregistré dans la table update_runs.
Une fois tous les trois jours, la mise à jour des statistiques
interroge l'API YouTube pour chaque vidéo déjà enregistrée dans
PostgreSQL. Comme celle des vidéos, elle s'exécute dans un
conteneur Docker éphémère sur le VPS, lancé par une tâche cron
puis supprimé une fois terminée. Chaque exécution écrit un
snapshot daté dans la table
stats : l'historique est ainsi conservé, même
lorsqu'une métrique n'a pas changé depuis le snapshot précédent.
docker compose -f docker-compose.yml -f docker-compose.prod.yml \
  --env-file .env.production \
  --profile jobs run --rm updater python -m pipeline.update_stats
La même opération synchronise les commentaires et leurs réponses : elle détecte les ajouts, les modifications et les suppressions. Elle ne télécharge pas de nouvelle vidéo et ne les publie pas dans le RAG ; cette responsabilité appartient à la mise à jour dédiée aux nouvelles vidéos.
Chaque exécution crée elle aussi un dossier daté dans le
stockage objet Scaleway, par exemple
youtube/20260912_1411_update_stats/, avec son bilan
(update_stats_log.json) : snapshots écrits,
commentaires ajoutés, modifiés ou supprimés, et erreurs
éventuelles.
Déploiement
Le RAG est déployé avec Docker sur un VPS, où quatre conteneurs tournent en permanence : l’API, qui sert aussi l’interface ; PostgreSQL équipé de pgvector, dont les données sont stockées dans un volume Docker ; Caddy, le reverse proxy qui reçoit le trafic et gère le HTTPS ; et Phoenix, qui collecte les traces du pipeline.
D’autres conteneurs n’apparaissent que ponctuellement : celui des mises à jour (nouvelles vidéos et statistiques), supprimé à la fin de chaque exécution, et une API et une base de staging, utilisées par le contrôle de recall avant un déploiement.

Le RAG tourne dans des conteneurs Docker sur un VPS. Une VM
avec GPU, éteinte le reste du temps, est disponible lorsqu’il
faut préparer de nouvelles vidéos pour le corpus. Les mises à
jour sont déployées automatiquement par GitHub Actions à chaque
push sur master : selon les fichiers modifiés,
l’image Docker concernée est recréée puis déployée sur la
machine qui l’utilise.
Cliquer pour plus de détails par image
En cas de modification du RAG
Recréation de l’image :
rag-ionis-api
Affecte : VPS
rag-ionis-api
Comment ?
-
Un runner GitHub vierge copie le repo au commit poussé, se connecte au registre Scaleway, puis lance
docker buildx buildsurDockerfile.api.Il télécharge d’abord le manifeste de
rag-ionis-api:buildcache: un index qui relie chaque clé de cache (l’empreinte d’une étape du Dockerfile) au sha256 de la couche qu’elle a produite.Il calcule ensuite la clé de chaque étape du Dockerfile et la compare au manifeste de
:buildcache. Si elle y figure, l’étape n’est pas réexécutée ; sinon, elle est reconstruite.Une étape reconstruite a besoin des couches qui la précèdent. Le commit modifiant en général le code, copié en dernier, le runner finit par télécharger presque toutes les couches : le cache évite surtout de recalculer, notamment l’installation des dépendances. Retélécharger une couche est bien plus rapide que la reconstruire.
Il publie enfin l’image dans le registre Scaleway avec le tag du commit et
latest, puis envoie une nouvelle version de:buildcachepour le build suivant. -
GitHub Actions se connecte au VPS en SSH, y copie les fichiers de configuration qui restent hors de l’image (Docker Compose, Caddyfile, scripts de déploiement et d’initialisation de la base), puis lui fait télécharger
rag-ionis-api:<sha du commit>depuis le registre Scaleway.Le VPS lit le manifeste de ce tag et ne télécharge que les couches qu’il n’a pas encore, identifiées par leur sha256.
-
GitHub Actions détecte si le commit modifie des fichiers qui affectent la recherche du RAG (backend, connaissances, dépendances, configuration de production). Si oui, le recall doit être testé à nouveau avant de mettre à jour le système.
La nouvelle image est d’abord lancée dans un conteneur de test (staging), avec sa propre base qui reçoit une copie du corpus, pour ne pas interférer avec le système en place. Le golden dataset y est rejoué : si le recall atteint 0,85, la mise à jour continue ; sinon, elle s’arrête et la production n’est pas touchée.
-
Le VPS exécute le script de déploiement : il inscrit le tag du commit dans sa configuration de production, puis remplace uniquement le conteneur de l’API par un nouveau, lancé avec la nouvelle image. La base et les autres services continuent de tourner.
Le remplacement entraîne une coupure de quelques secondes : entre l’arrêt de l’ancien conteneur et le démarrage du nouveau, l’API ne répond plus.
-
Le script vérifie ensuite, pendant 3 minutes au maximum, que la nouvelle API répond sur son adresse de santé (
/health). Si c’est le cas, Caddy est rechargé et le déploiement se termine.Sinon, l’ancien tag est remis dans la configuration et l’ancienne version est relancée : l’API ne reste pas en panne si la nouvelle image ne démarre pas.
En cas de modification du pipeline de préparation
Recréation de l’image :
rag-ionis-scaleway
Affecte : VM avec GPU
rag-ionis-scaleway
Comment ?
-
GitHub Actions détecte une modification du pipeline (code, Dockerfile, dépendances GPU ou modèle) et lance d’abord des contrôles sur un runner GitHub.
L’image GPU étant trop lourde pour un runner gratuit, elle est construite ensuite sur un runner auto-hébergé, le PC local, qui garde les couches des builds précédents.
Le PC télécharge quand même le manifeste de
rag-ionis-scaleway:buildcache, mais compare chaque clé de cache d’abord à son cache local, plus complet : celui du registre ne garde que les couches de l’image finale, alors que le PC conserve aussi les étapes intermédiaires et les paquets déjà téléchargés. Le cache du registre ne sert donc qu’en secours, si le cache local a été vidé. -
Une fois l’image construite, le PC l’envoie directement dans le registre Scaleway (
docker push, via l’API HTTPS du registre). Pour chaque couche, il demande au registre s’il possède déjà son sha256 : seules les couches absentes sont envoyées. L’image est publiée avec le tag du commit etlatest, puis:buildcacheest mis à jour. -
L’image n’est pas envoyée à la VM, qui reste éteinte hors traitement. À chaque démarrage, un service de la VM fait automatiquement un
docker pullderag-ionis-scaleway:latest, en ne téléchargeant que les couches qui lui manquent, puis lance le conteneur worker sur le GPU.
En cas de modification du pipeline de préparation
Recréation de l’image :
rag-ionis-updater
Affecte : VPS
rag-ionis-updater
Comment ?
-
GitHub Actions détecte une modification du pipeline, de
Dockerfile.vpsou des dépendances. Cette image légère, sans GPU, est construite sur un runner GitHub vierge, comme l’image de l’API, avec le cache du registre (rag-ionis-updater:buildcache).Elle est publiée dans le registre Scaleway avec le tag du commit et
latest. Aucun test de recall n’est lancé : ce conteneur ne sert pas à la recherche. -
GitHub Actions se connecte au VPS en SSH, y copie les fichiers de configuration qui restent hors de l’image (Docker Compose, qui décrit le conteneur updater, Caddyfile et scripts), puis lui fait télécharger
rag-ionis-updater:<sha du commit>, en ne récupérant que les couches qui lui manquent.Le VPS inscrit ce tag dans sa configuration de production, sans lancer le conteneur : l’image est seulement préparée.
-
La nouvelle version est utilisée au prochain passage de la tâche cron : le VPS lance un conteneur éphémère avec cette image, qui ajoute les nouvelles vidéos ou met à jour les statistiques, pilote la VM GPU si besoin, puis est supprimé.


Problèmes rencontrés
Préparation des données
RAG et réponse
L’image Docker du worker GPU dépasse 23 Go : elle embarque notamment Torch, WhisperX, PaddleOCR et leurs dépendances CUDA. Elle ne tient donc pas sur le disque de 14 Go d’un runner GitHub standard gratuit.
Il a donc fallu paramétrer le workflow pour qu’il exécute la construction de l’image sur un PC personnel, configuré comme runner auto-hébergé.
Deux modèles ont été envisagés : le L4, le plus petit et le moins cher, et le L40S, plus puissant mais plus coûteux. Le L4 est déjà suffisamment puissant pour ce traitement. Cependant, des appels réguliers à l’API de disponibilité de Scaleway ont montré qu’il était très rarement disponible à la création d’une instance.
Le pipeline a donc d’abord tourné sur des L40S. Il utilise désormais une VM L4 dédiée, créée une fois puis conservée : elle est simplement démarrée pour chaque traitement et arrêtée ensuite, ce qui ne dépend plus de la disponibilité des GPU au moment du lancement.
En plus de son coût lorsqu’elle est allumée, la VM Scaleway a besoin d’une adresse IP et d’un Block Storage associé, ce qui fait encore grimper la facture.
Le choix a donc été fait de ne jamais laisser la VM allumée : elle est démarrée uniquement pour traiter un job, puis arrêtée automatiquement dès qu’il est terminé. Seuls son volume et son adresse IP restent facturés hors traitement.
Au départ, les artefacts étaient stockés sur AWS S3. Cela ajoutait toutefois un fournisseur de plus à gérer.
Scaleway proposant désormais aussi du stockage objet compatible S3, cette partie y a été migrée afin de simplifier l’infrastructure et de centraliser les services chez un même fournisseur.
Au départ, l’idée était aussi d’intégrer aux métadonnées les mots-clés présents dans les vidéos. L’OCR effectuait un premier travail, mais restait imparfait : certains mots du décor étaient détectés, les mots-clés animés compliquaient encore l’extraction, et des mots isolés perdaient parfois tout leur sens sans les autres mots du groupe. De plus, les mots-clés n’apparaissaient pas toujours tous en même temps à l’écran, ce qui compliquait davantage leur regroupement et leur interprétation.
Un appel LLM a ensuite été ajouté pour chaque mot-clé détecté afin que GPT‑4.1 confirme ou non sa pertinence. Le prompt utilisé était : « Voici 2 screenshots d’un supposé mot-clé ajouté au montage, détecté via OCR, confirmes-tu son ajout au montage ? »
Malgré l’envoi des requêtes en mode batch, le coût de vérification de tous les mots-clés était trop élevé. L’idée a donc été abandonnée. Ce n’est pas impossible, mais la priorité est allée aux besoins essentiels.
Un script final repère les speakers dont les orthographes sont très semblables, par exemple à cause d’une faute de transcription ou d’un accent. Il demande ensuite comment les dédupliquer afin de rattacher les différentes variantes à un même intervenant.
Dans les montages, les questions n’apparaissent pas toujours d’un coup à l’écran. Il a donc fallu gérer une continuité entre les détections OCR de plusieurs frames, afin de reconstituer une même question au fur et à mesure de son apparition. Ce rapprochement doit également tolérer les petites erreurs de lecture que l’OCR peut produire d’une frame à l’autre.
Grâce à Phoenix, on sait précisément quelles étapes sont les plus coûteuses en temps lors de la préparation d’une réponse : il s’agit principalement des appels aux API de LLM. L’enjeu est donc de réduire leur nombre. Par exemple, le LLM qui détectait une nouvelle question et le LLM de reformulation ont été fusionnés dans un seul appel.
Des tests ont ensuite permis de comparer le meilleur compromis entre délai, prix et qualité selon les fournisseurs. OpenAI répondait trop lentement, malgré l’utilisation de GPT‑5.6 Luna, un petit modèle, et du mode Fast. Gemini et Mistral offraient de bien meilleurs délais ; le choix s’est finalement porté sur Mistral.
 OpenAI
 Gemini
 Mistral
Des tests en lot, organisés sous forme d’expériences Phoenix, ont ensuite confirmé ces hypothèses sur la latence, le coût et la qualité des réponses.
Au fil du projet, le principal risque a été de trop travailler le pipeline de réponse pour l’adapter à chaque question posée. À force d’ajouter des cas particuliers, le pipeline se transforme en un sac de nœuds difficile à comprendre.
Il a donc fallu prendre du recul et le revoir entièrement pour construire un pipeline plus simple à comprendre, à maintenir et à améliorer.
Mistral a récemment annoncé servir le modèle GLM‑5.2. Les tests ont montré qu’il offrait le meilleur compromis entre vitesse, qualité des réponses et coût.
Cependant, malgré la demande d’une réponse au format JSON Schema, le modèle renvoyait souvent des JSON incomplets. Le choix a donc été fait de basculer vers Mistral Medium Latest. Ces réponses incomplètes bloquaient toute la suite du pipeline, qui dépend des champs attendus pour continuer son exécution.
Chaque fournisseur attend un payload différent. OpenAI passe par LangChain et son mode de sortie structurée, Mistral attend des messages et un response_format spécifique, tandis que Gemini sépare l’instruction système, les contenus et le schéma JSON dans sa configuration.
Une couche d’adaptation dédiée a donc été créée. Elle normalise d’abord toutes les entrées dans un même format de messages (system, user, assistant), puis choisit le fournisseur à partir du nom du modèle et construit le payload correspondant à son SDK.
Quelle que soit l’API appelée, cette couche renvoie ensuite le texte et le payload brut dans un format unique. Les réponses JSON sont enfin relues et vérifiées contre les champs obligatoires du schéma avant d’être utilisées par le pipeline.
Une petite app a été créée pour visualiser les payloads envoyés aux fournisseurs LLM.
Une première solution consistait à créer un embedding pour chaque sujet de conversation, puis à effectuer une recherche vectorielle dans l’historique de la conversation. Cette approche fonctionnait, mais elle ajoutait de la complexité.
Une solution plus simple a finalement été retenue. La mémoire est organisée par sujets : le sujet actif reste prioritaire, les sujets quittés sont résumés et, après dix sujets, leurs résumés sont consolidés dans un résumé global. Ce compromis conserve le contexte utile sans envoyer toute la conversation à chaque tour.
L’OCR renvoie d’abord tous les textes qu’il voit dans les images, sans savoir s’il s’agit de sous-titres, d’un titre, d’un décor ou d’un cartouche. Un script applique ensuite une série de règles pour déterminer quels textes sont réellement des sous-titres. Cette logique a été travaillée et affinée au fil des mauvaises classifications rencontrées.
Pour qu’un groupe soit considéré comme des sous-titres, toutes les conditions suivantes doivent être respectées :
- Le texte doit avoir une taille plausible de sous-titre : une hauteur comprise entre 1,8 % et 9 % de l’image.
- Les boxes de toutes les frames sont regroupées par position (tolérance de 16 % en horizontal et 5,5 % en vertical) : le groupe doit rester au même endroit de l’écran.
- Le groupe doit être centré horizontalement autour du milieu de l’image : 50 % ± 10 %.
- Le signal doit persister de manière continue pendant au moins 10 secondes.
- Il doit contenir au moins trois variantes de texte.
Le texte peut évoluer pendant la phrase ; les variantes très proches sont regroupées afin de tolérer les petites erreurs de lecture de l’OCR (seuil de similarité de 0,82). Enfin, les répétitions sur des frames voisines sont filtrées.
Détecter le type de vidéo permet d’adopter le bon pipeline de préparation. Cela aide aussi à repérer les interviews et, par exemple, les questions graphiques qui les entrecoupent.
Une interview est souvent constituée d’un plan fixe, entrecoupé de questions graphiques. À l’inverse, les vidéos best-of ou de motion design contiennent de nombreuses images différentes. Ces indices visuels permettent de distinguer les grands types de vidéos.
Des essais avec des scripts fondés sur la luminance, la variance des images et d’autres mesures simples n’ont pas permis d’obtenir une détection suffisamment fiable. Un modèle personnalisé a donc été entraîné à partir d’images annotées dans trois classes : prises de vue réelles (footage), visuels entièrement graphiques (graphic) et prises de vue mêlées à des éléments graphiques importants (mixture).
Chaque image est représentée par la concaténation de deux embeddings issus de DINOv2 et de CLIP, soit un vecteur de 1 280 dimensions. Ces représentations alimentent un classifieur par régression logistique qui classe les frames.
Après la classification des images par le modèle, les conditions suivantes déterminent le type de chaque vidéo et donc le traitement correspondant :
- Une vidéo de plus de 10 minutes (600 secondes) est directement classée comme vidéo longue, avant toute autre règle : elle reçoit en plus des chunks résumés.
- Pour détecter une interview, le pipeline n’analyse que les frames du dossier footage. Grâce aux embeddings DINOv2 (sans CLIP), il repère la frame qui ressemble au plus grand nombre d’autres frames (similarité cosinus d’au moins 0,88) ; le groupe réunit cette frame et ses frames proches visuellement. Ce groupe stable doit représenter au moins 50 % des frames footage et au moins 30 % de toutes les frames de la vidéo. Lorsque ces deux seuils sont atteints, la vidéo est considérée comme une interview.
- Une vidéo courte (moins de 180 secondes) est classée comme un motion design si moins de 15 % de ses frames sont footage, ou si aucune frame n’est classée footage.
- Si aucune de ces conditions n’est remplie, la vidéo est traitée comme un enregistrement vidéo classique.
Ces règles sont vérifiées dans cet ordre : vidéo longue, puis interview, puis motion design, puis enregistrement vidéo classique. Le premier type reconnu l’emporte.
Pour voir le projet du modèle classifieur d’images, cliquez ici.